4 min de lecture
DataTour 2026 : pourquoi calibrer mon modèle m'a fait perdre des points
En juin 2026, j'ai participé avec mon équipe Winner299 à la phase nationale du DataTour, la Coupe d'Afrique des Nations en Science des Données (CANSD), organisée par Data Afrique Hub du 13 juin au 4 juillet. Le défi : estimer, pour chaque transaction mobile money, la probabilité qu'elle soit frauduleuse. La métrique : l'Average Precision, autrement dit l'aire sous la courbe précision-rappel (PR-AUC).
Regarder les données avant de choisir un modèle
Le jeu d'entraînement compte environ 1,29 million de transactions, le test environ 430 000. Deux observations ont tout changé, avant même d'entraîner quoi que ce soit.
- Toutes les fraudes se trouvent dans un seul type d'opération. Les quatre autres types n'en contiennent aucune. Je n'ai donc modélisé que ce type d'opération, et donné une probabilité nulle au reste.
- Le découpage est temporel. L'entraînement couvre les périodes 0 à 105, le test les périodes 106 à 143. Le test, c'est le futur.
Le temps est une variable piégée
Dans ce type d'opération, le taux de fraude dérive : autour de 49 % au début, autour de 30 % à la fin. Donner le numéro de période au modèle lui aurait appris une tendance qui ne se prolonge pas forcément dans le test. J'ai donc écarté la période brute des variables, et validé sur les périodes 90 à 105, comme une répétition générale du vrai test.
Décrire le comportement, sans fuite
99 % des comptes du test apparaissent déjà dans l'entraînement. L'historique de chaque compte devient donc précieux, à condition de ne jamais laisser le modèle voir l'avenir. J'ai construit :
- un taux de fraude cumulé par compte, calculé uniquement sur les transactions passées ;
- un encodage de la cible par compte, calculé en validation croisée pour éviter la fuite ;
- des variables de réseau, comme le nombre d'expéditeurs distincts qui envoient vers un même destinataire.
Le modèle final est un ensemble de LightGBM entraînés avec plusieurs graines, dont je moyenne les rangs.
L'erreur qui m'a coûté un centième
En fin de compétition, le classement était extrêmement serré : les neuf premières équipes tenaient entre 0,3560 et 0,3577. Mon score sur la plateforme plafonnait à 0,3531, alors que ma validation annonçait mieux. En cherchant l'écart, j'ai trouvé le coupable : une étape de calibration isotonique ajoutée à la fin du pipeline.
L'Average Precision ne dépend que de l'ordre des prédictions :
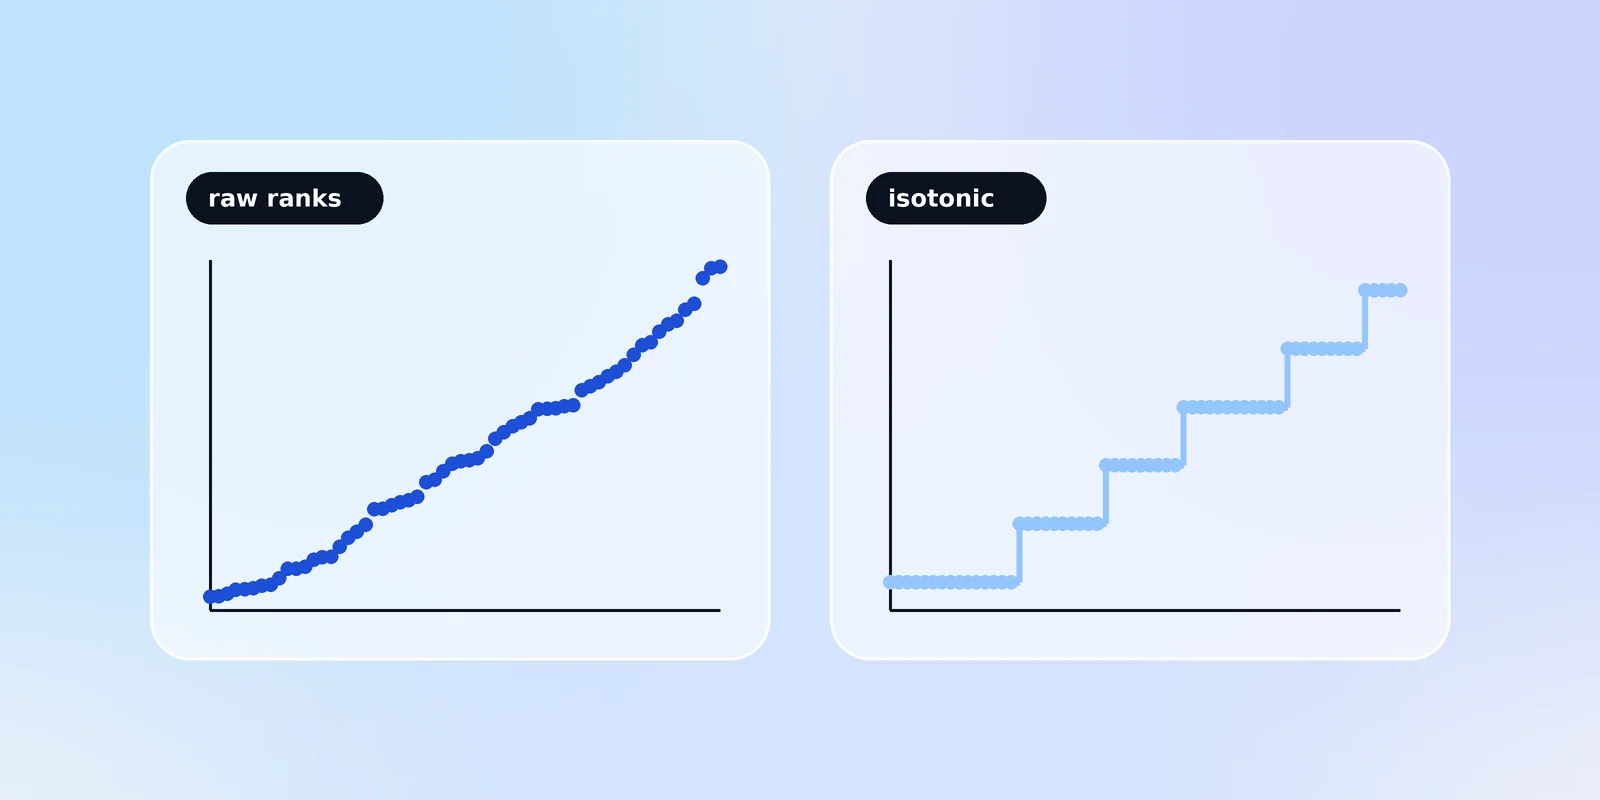
où et sont la précision et le rappel au -ième seuil. Multiplier toutes les probabilités par deux ne change rien : seul compte qui passe devant qui. Or la régression isotonique produit une fonction en escalier. Sur ma validation, elle a écrasé environ 21 000 scores différents en seulement 16 valeurs. Des milliers de transactions se retrouvent à égalité, et le modèle perd sa capacité à les départager.
Mesuré sur la même validation : 0,3609 avant calibration, 0,3509 après. Un centième perdu, ce qui expliquait l'essentiel de l'écart avec ma soumission. La correction tient en deux lignes : sortir le classement brut, sans aucune calibration.
from scipy.stats import rankdata

# Sortie finale : le classement brut, normalisé entre 0 et 1.
scores = rankdata(raw_scores) / len(raw_scores)
Un signal faible, une validation bruitée
Dernière leçon : le signal était faible par nature, avec des corrélations d'au plus 0,12 entre les variables et la cible. Dans ces conditions, la validation elle-même devient bruitée. Selon la fenêtre choisie, le même modèle obtenait 0,366, 0,347 ou 0,361. J'ai donc regroupé toute la fenêtre 90 à 105 et moyenné dix graines avant de comparer deux idées. Sans ça, j'aurais pris du bruit pour un progrès.
Ce que j'en retiens
- Vérifier que chaque étape respecte la métrique. Une calibration améliore des probabilités, pas un classement.
- Comprendre la structure des données (où se trouve la fraude, comment le temps est découpé) rapporte plus que n'importe quel réglage d'hyperparamètres.
- Mesurer le bruit de sa propre validation avant de célébrer une amélioration, surtout quand tout se joue au millième.